容器、虚拟机、Agent 沙箱,启动方式都一样:从一个镜像开始。然而主流镜像格式都是为单一负载设计的——容器用 OCI tar+gzip 分层格式,虚拟机用 qcow2/VHD/VMDK——各自的结构性成本只会随规模增长而愈发严重。
Overlaybd 另辟蹊径:分层的、按需加载的、可寻址压缩的块设备镜像格式。一种格式,同时覆盖容器、VM隔离的安全容器、Agent沙箱和完整的虚拟机,并且已在世界上最大规模的生产环境中历练多年。本文就来展开论证这一点。
现有两大阵营,为何都不够用
现有镜像技术栈可以分成两个架构阵营:
- 基于文件系统的镜像。 主流的 OCI tar+gzip 格式通过 overlayfs 提供服务;懒拉取变体(eStargz、SOCI)把解包推迟到运行时,但甩不掉 tar 和文件系统语义;单一文件系统镜像(squashfs、EROFS);以及基于 FUSE 的格式(Nydus/RAFS)。
- 基于块设备的虚拟磁盘。 qcow2、VHD/VHDX、VMDK——都是"一个虚拟块设备 + 一张固定粒度的分配表",一个快照一个文件,串成链。
拿这些负载的真实需求来对照——亚秒级冷启动、数千实例并发下的效率、作为业务关键基础设施的稳定与安全、跨运行时和跨客户机系统的统一格式——两个阵营都差在架构上。
冷启动
标准 OCI 镜像必须完整下载、解压、解包之后,进程才能跑起来——尽管启动时真正访问到的数据只占很小一部分。镜像有几个 G,这一步就是几十秒到几分钟。P2P 工具(Dragonfly、 Kraken)能加速分发,却省不掉下载和解压。懒拉取变体把解包推迟了,但仍然受限于归档结构和文件系统语义。
查找开销随深度线性增长
文件系统堆叠下,每次文件访问——open、stat、readdir——都要自上而下逐层找目录树,复杂度随层数 O(n) 增长。VM 阵营也有同样的毛病,只是换了个形态:qcow2/VHD/VMDK
快照链上的一次读未命中,要逐级向下穿透父文件,直到某个快照里找到数据为止。厂商自己的建议就把问题说得很清楚——VMware 一条链最多支持 32 个快照、推荐 2–3 个;微软把“超过 50个检查点”列为问题;QEMU 专门提供了 block-commit/block-stream
来收拢链。分发模型要求深栈(基础 OS、运行时、依赖、应用、每租户定制),这些格式却只受得了浅栈。
索引内存,随链深成倍放大
qcow2 的两级 L1/L2 表,在默认 64 KB 簇大小下每 100 GB 虚拟磁盘要约 12.5 MB——注意这是每个文件的开销,快照链上每一环都得自带一张表、一份缓存。30 个快照就是 30 × 12.5 MB 的索引。而 QEMU 默认的 L2 缓存只有约 1 MB,逼你二选一:要么多占宿主机内存,要么忍受缓存频繁未命中带来的额外 I/O。VMDK 和 VHD/VHDX 只是在这条权衡曲线上选了不同的点(用更粗的粒度换更小的表)。
粒度困境
对固定粒度的表来说,索引大小正比于"虚拟容量 ÷ 簇大小",写时复制的成本正比于簇大小。簇小,写入便宜、表巨大;簇大,表是小了,但一次 4 KB 的写可能触发好几 MB 的复制。固定粒度格式都逃不出这条曲线——你只能沿着它移动,没法跳出去。文件系统格式也有类似的税要交,形式是文件级 copy-up:第一次修改下层数据,得把整个文件复制上来。
服务路径的复杂与安全
基于文件系统的格式,必须在宿主机或 hypervisor 里解析复杂的元数据(xattrs、ACL、符号链接、设备节点),而这些内容来自不可信的客户机——攻击面天然就大。送进 VM 之后,每个元数据操作都变成一次 FUSE/virtio-fs 往返,嵌套路径上的一次open() 可能要付出五次甚至更多次跨 VM 往返。更糟的是,virtio-fs/9p 已被证明能让客户机完全绕开内存 cgroup 和临时存储的配额计量(kata-containers#12203)。此外,用户态 FUSE 守护进程一旦崩溃,挂载的文件系统通常直接挂死——对 7×24 小时运行的基础设施来说,这是不小的隐患。
Overlaybd 的优势
Overlaybd 把每个镜像呈现为一个虚拟块设备,背后是一摞块级的层。从这一个决定出发的一系列设计,恰好逐一化解了上面的问题。
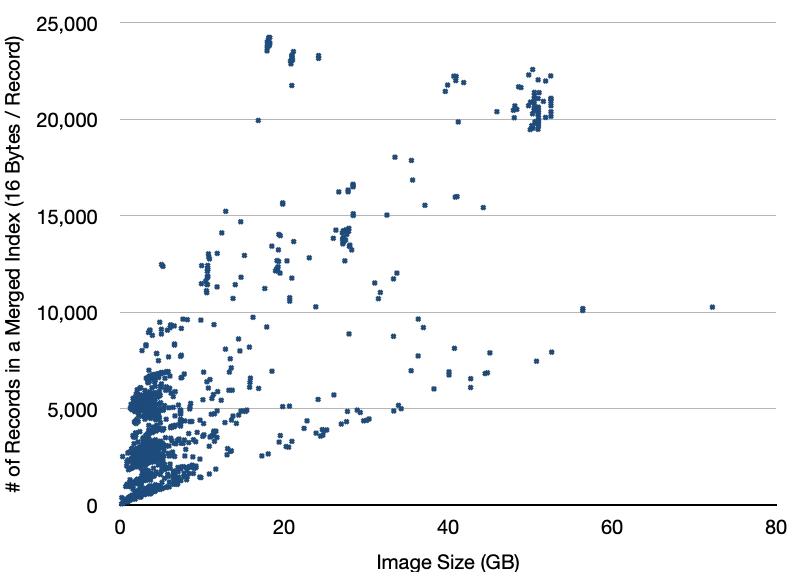
合并的 extent 索引:任意深度都是 O(1)
镜像加载时,overlaybd 把所有层的索引合并成一张 LSMT 索引,由变长的 extent 记录组成(每条 16 字节)。从此链深跟数据路径无关:镜像有两层还是五十层,一次读都只需查这一张索引。索引大小看的是碎片化程度,而不是虚拟容量——在阿里巴巴的生产环境中,大于 50 GB 的镜像,合并索引平均不到 300KB,小到哪怕几千个实例并发,也能全部常驻内存。
为速度而生的查询引擎
LBA 查找,本质是在一组有序、互不重叠的区间里做段搜索。Overlaybd 把原来的
std::lower_bound 二分查找换成了线性化 B+ 树,配合 AVX-512 批量比较做向量化——快了 10 倍以上,单核每秒能扛数亿次查找:
| 段数量 | B+树 + AVX-512 | B+树 + 位掩码循环 | std::lower_bound |
|---|---|---|---|
| 1K | 220 M/s | 42.2 M/s | 18.3 M/s |
| 10K | 160 M/s | 30.7 M/s | 12.8 M/s |
| 100K | 108 M/s | 21.8 M/s | 8.6 M/s |
| 1M | 57.4 M/s | 15.2 M/s | 5.6 M/s |
这个算法快到什么程度?它甚至能用在骨干网核心路由器的 IP 地址查找上(见我的论文 PlanB, NSDI'26)。
扇区级写入:永远无需写时复制
可写层是格式本身的一部分,按 512 字节扇区粒度建索引——这已经是任何块 I/O 的最小单位——所以一次写必然覆盖整扇区,永远触发不了复制。写入成本只跟写入大小有关,跟文件或簇的大小无关。这正是打破粒度困境的关键:映射粒度和写入粒度解耦,索引小和写入便宜,两个都要。
按需拉取与可寻址压缩
容器和 VM 按需从远端读数据就能启动,1 GB 以上的镜像也能在一秒内起来。数据被压缩成一个个小的、可独立寻址的单元(ZFile,LZ4/zstd),随机读只需取回并解压命中的那个单元;压缩后传输量更小,所以压缩随机读往往比不压缩还快。基于访问踪迹或文件列表的预取,可以提前把缓存预热好;数千实例同时启动时,P2P 分发还能把拉块的压力摊到各个节点上。
无状态、极简的服务路径
宿主机看到的只是一串块读写:不解析文件系统结构,不解释符号链接和 xattrs,也不跟客户机共享任何会话状态——每个请求都自带服务它所需的全部信息。由此带来的好处是一连串的:攻击面就是块接口本身,那是计算领域最古老、最久经考验的边界之一;服务崩了,重新挂接设备就能恢复;快照、克隆、跨机恢复、迁移,都简化成"一次磁盘同步 + 能访问同一组后备层"——对动辄要在试探性分支上 fork 的 Agent 沙箱来说,这一点是决定性的。用户态块服务构建在 PhotonLibOS 之上,这个协程运行时轻松支撑数万路并发 I/O,没有一个连接配一个线程的开销。
一种格式,承载所有负载
块设备是计算领域最通用的存储抽象——凡是能挂块设备的,就能用 overlaybd:
- 容器(runc):看到的是宿主机上从设备挂载出来的普通 ext4 文件系统,通过 containerd snapshotter 和 OCI 镜像仓库生态交付。
- 安全容器(Kata、Firecracker):通过 virtio-blk 挂接设备,元数据操作全部在客户机内部完成,零跨 VM 往返,只有数据 I/O 过边界。
- Agent 沙箱:亚秒级冷启动、廉价的快照/fork、对不可信代码的强隔离,加上共享基础镜像撑起来的大规模并发。
- 虚拟机:用合并的 extent索引取代按文件维护的分配表,链再深查找也是 O(1),还能直接复用现有镜像仓库,获得 OCI 风格的分层分发。
- 任意客户机操作系统:Linux、Windows、Android、macOS,都认块设备,不需要装任何 guest 代理或内核模块。里面用什么文件系统随便挑:ext4、XFS、Btrfs、EROFS、NTFS。
值得一提的是,EROFS 对 O(n) 逐层遍历问题的回答——预先构建合并视图、压平到单个块设备上给 VM 直通——本身就等于承认了同一个结论:要跳出文件系统堆叠,出路就是块设备。
生产环境验证
这不是实验室里的研究原型:
- 阿里巴巴:overlaybd 在淘宝、天猫、阿里云等全部业务线上跑了多年,并在阿里云上商业化,成为容器镜像加速服务;函数计算的函数 microVM 也跑在同一架构上。
- Azure: AKS Artifact Streaming 构建在 overlaybd 之上。
- Databricks:报告 serverless 计算的 VM 启动快了 7倍; Superhuman 在同一套基础设施上搭出了 200K QPS 的推理平台。
- DeepSeek Elastic Compute: Agent 执行环境跑在 overlaybd 格式的镜像上。
- fly.io:用 overlaybd 镜像启动 Firecracker microVM; hocus.dev:用它支撑microVM 开发环境。
- Google Colab: 27 GB 的运行时镜像,热启动约 170 ms,冷启动约 5.6 s。
- Kimi AgentEnv(月之暗面):独立重新实现了这个开放格式,作为沙箱镜像底座,做到了亚秒级启动。
这套设计本身也经过了同行评议: DADI (ATC'20)描述了阿里巴巴的大规模部署, FaaSNet (ATC'21)则把它用在了函数计算上。
开源
Overlaybd 是 containerd(CNCF 毕业项目)旗下的开源子项目,Apache-2.0 许可证,规范文档齐全( LSMT、 ZFile),任何人都可以独立实现:
- 数据 I/O 路径:containerd/overlaybd
- Snapshotter 与转换工具:containerd/accelerated-container-image
- P2P 分发:data-accelerator/dadi-p2proxy
结语
传统格式总要让你取舍:冷启动快、元数据小、写入便宜、运行时通用,几样不可兼得。 Overlaybd 的块级设计——合并的 extent 索引、扇区级写入、按需的可寻址压缩拉取、无状态的块设备服务路径——把这些取舍一次性抹平,而且是用同一种格式服务所有使用方。对需要大规模启动、打快照、分发负载的基础设施来说,它是更扎实的地基。